사이트를 새로 만들었는데 검색에 본문이 하나도 잡히지 않는다는 문의를 받으면, 저희는 브라우저에서 페이지를 여는 대신 자바스크립트를 끄고 같은 주소를 엽니다. 화면이 텅 비어 있다면 원인의 절반은 거기서 설명됩니다. 사람이 보는 화면과 검색엔진이 처음 받아 가는 문서가 같지 않기 때문입니다.
크롤과 색인 사이에는 한 단계가 더 있습니다
구글의 자바스크립트 SEO 기본 가이드는 구글봇이 자바스크립트 기반 페이지를 크롤링, 렌더링, 색인 생성의 세 단계로 처리한다고 설명합니다. 앞선 글에서 다룬 크롤·색인·서빙의 3단계와는 층위가 다른, 크롤과 색인 사이를 확대한 그림입니다.
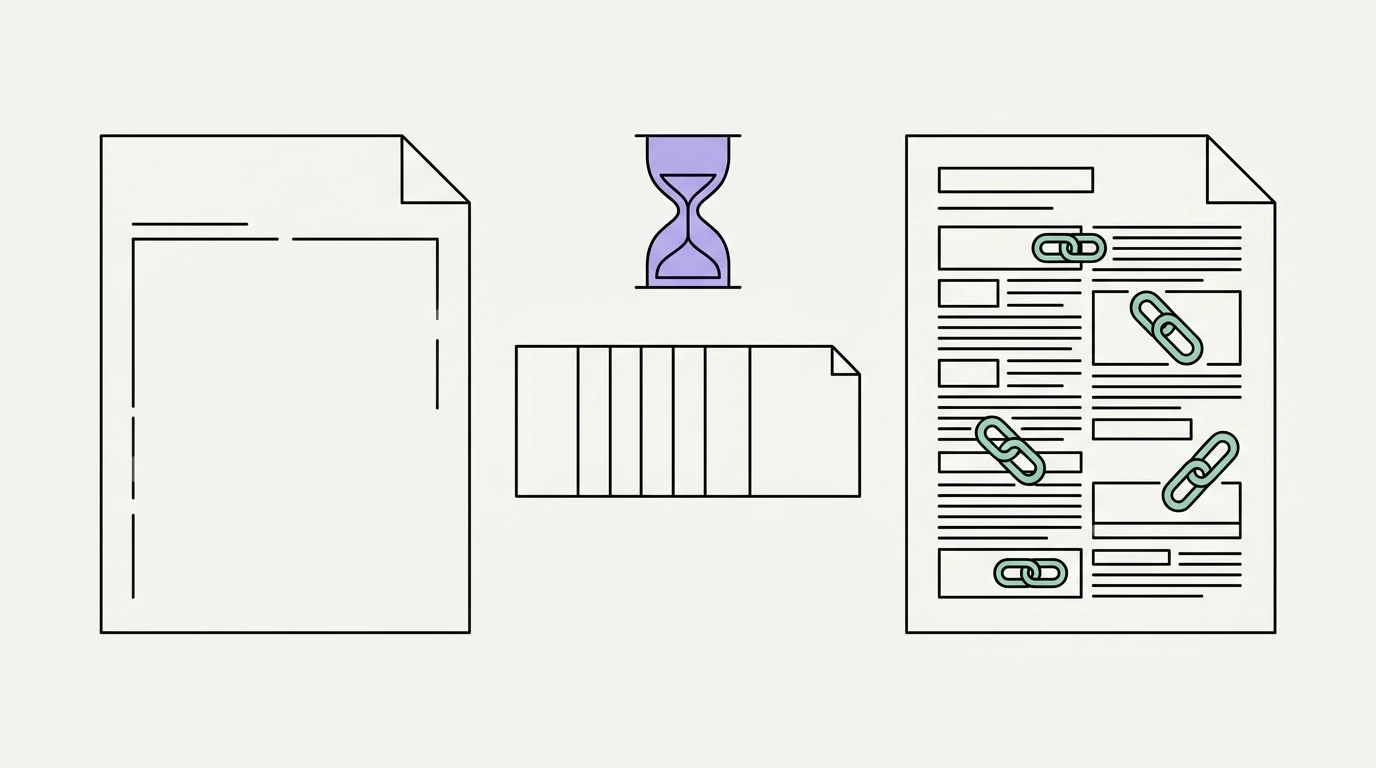
크롤링 단계에서 구글봇은 URL을 가져와 robots.txt 권한을 확인하고, 응답을 파싱해 HTML 링크의 href 속성에 있는 다른 URL들을 찾아 크롤 대기열에 넣습니다. 이 시점에 읽는 것은 서버가 처음 내려준 HTML입니다. 자바스크립트는 아직 실행되지 않았습니다.
렌더링은 그다음입니다. HTTP 200으로 응답한 페이지는 렌더링 대기열에 들어가고, 구글 문서의 표현으로는 “리소스가 허용하는 시점에 헤드리스 Chromium이 페이지를 렌더링하고 자바스크립트를 실행”합니다. 구글은 이때 에버그린 버전의 Chromium을 쓴다고 밝히고 있어, 최신 브라우저가 지원하는 문법은 대체로 문제가 되지 않습니다. 렌더링이 끝나면 구글봇은 렌더링된 HTML에서 링크를 다시 추출해 크롤 대기열에 넣고, 이 렌더링된 HTML로 색인을 생성합니다.
대기열은 즉시 처리되지 않습니다
여기서 실무상 가장 중요한 문장은 대기 시간에 관한 것입니다. 구글은 페이지가 렌더링 대기열에 “몇 초간 머물 수도 있지만 그보다 오래 걸릴 수도 있다”고 적고 있습니다. 시간을 명시하지 않은 것 자체가 신호입니다. 렌더링은 크롤보다 비싼 작업이라 자원 사정에 따라 미뤄집니다.
이 지연이 만드는 손해는 두 가지입니다. 하나는 콘텐츠 색인이 늦어지는 것이고, 다른 하나는 링크 발견이 한 박자 늦어지는 것입니다. 초기 HTML에 없고 자바스크립트로만 그려지는 링크는 크롤 단계의 링크 추출을 통과하지 못하고, 렌더링이 끝난 뒤에야 비로소 발견됩니다. 새 글을 올렸는데 목록 페이지가 클라이언트 렌더링 방식이라면, 구글이 그 글의 존재를 아는 시점부터 밀립니다.
백링크에도 같은 규칙이 적용됩니다
이 구조는 백링크를 평가할 때 그대로 적용됩니다. 링크가 게재된 페이지를 브라우저로 열어 링크가 보인다고 해서, 그 링크가 초기 HTML에 있다는 보장은 없습니다. 댓글 위젯, 무한 스크롤로 불러오는 목록, 자바스크립트로 조립되는 사이드바에 걸린 링크는 사람 눈에는 멀쩡하지만 검색엔진에게는 한 단계 뒤에 도착하는 링크입니다.
확인 방법은 어렵지 않습니다. 브라우저에서 페이지 소스 보기를 열어 내 도메인을 검색해 보는 것으로 1차 판별이 됩니다. 소스에 없고 개발자 도구의 요소 탭에만 있다면 렌더링 이후에 생긴 링크입니다. 더 확실하게는 서치 콘솔의 URL 검사에서 실제 URL 테스트를 돌리고, 테스트된 페이지의 HTML을 열어 링크가 남아 있는지 보면 됩니다. 구글이 실제로 렌더링한 결과물을 직접 보여주기 때문에 추측할 필요가 없습니다.
렌더링을 전제로 설계하는 법
자바스크립트를 쓰지 말라는 이야기가 아닙니다. 구글 문서도 “웹사이트가 콘텐츠를 페이지에 표시하기 위해 자바스크립트에 의존하는 경우가 많다”는 현실을 인정하고 렌더링 단계를 둔 것입니다. 요점은 검색에 남아야 하는 것을 렌더링 결과에 의존시키지 않는 것입니다.
실무 기준은 셋으로 정리됩니다. 첫째, 본문 텍스트와 내부 링크, 메타 태그는 서버 렌더링이나 정적 생성으로 초기 HTML에 담습니다. 둘째, 링크는 href 속성을 가진 <a> 태그로 씁니다. 클릭 이벤트로 페이지를 이동시키는 요소는 구글이 링크로 인식하지 못합니다. 셋째, 자바스크립트와 CSS 파일을 robots.txt로 차단하지 않습니다. 차단하면 구글이 렌더링을 제대로 수행하지 못해, 사용자가 보는 것과 전혀 다른 페이지를 색인하게 됩니다.
프레임워크 선택 자체가 문제인 경우는 드뭅니다. 요즘 쓰이는 대부분의 프런트엔드 프레임워크는 서버 렌더링이나 정적 생성 모드를 갖추고 있어서, 렌더링 방식을 페이지 성격에 맞게 고르면 됩니다. 판단 기준은 단순합니다. 검색으로 유입되어야 하는 페이지, 즉 블로그 글이나 제품 상세, 서비스 소개 같은 것들은 초기 HTML에 내용이 담기는 방식으로 만들고, 로그인 후 대시보드처럼 애초에 검색 대상이 아닌 화면은 클라이언트 렌더링으로 둬도 손해가 없습니다. 어차피 색인에서 제외할 페이지에 서버 렌더링 비용을 들일 이유는 없습니다.
보이는 것과 읽히는 것
렌더링 단계가 존재한다는 사실은 검색엔진 최적화에서 “보이는 것”과 “읽히는 것”을 분리해서 생각해야 하는 이유를 설명합니다. 사람에게 보이는 화면은 브라우저가 자바스크립트를 다 실행한 최종 상태이지만, 검색엔진에게 그 상태는 조건부로, 뒤늦게 도착하는 정보입니다. 저희가 링크를 게재한 뒤 게재 페이지의 초기 HTML을 확인하는 절차를 두는 것도 이 때문입니다. 스크린샷으로 증명되는 링크와 검색엔진이 계산에 넣는 링크는 같은 것이어야 합니다.